퀵 정렬의 분할 정복 과정 이해하기
피벗을 기준으로 배열을 나누고 재귀적으로 정렬하는 퀵 정렬의 과정과 시간 복잡도를 살펴봅니다.
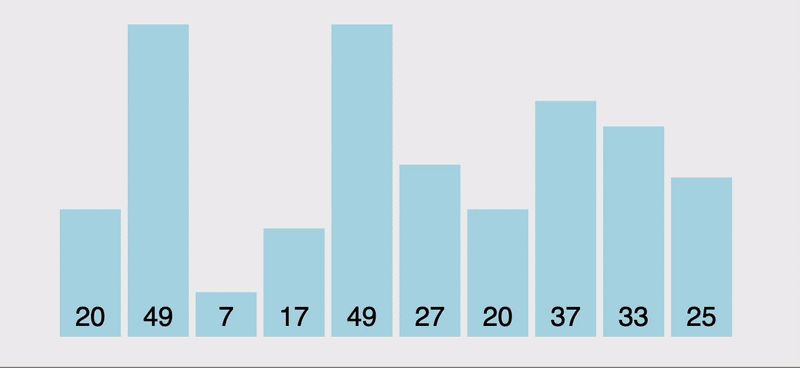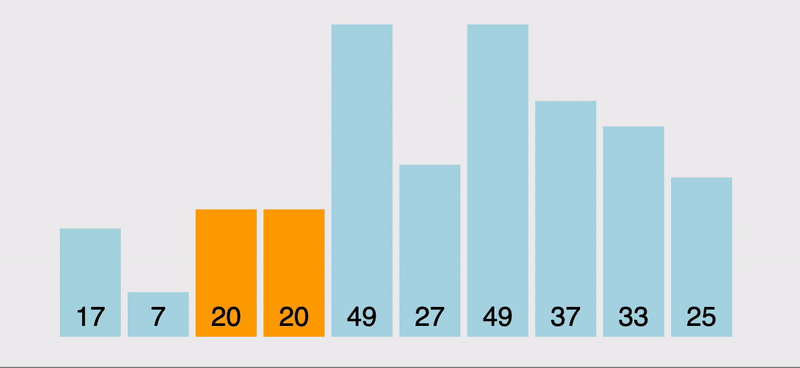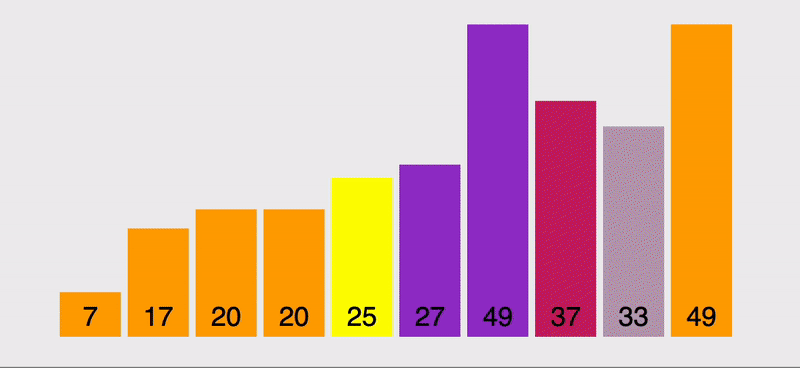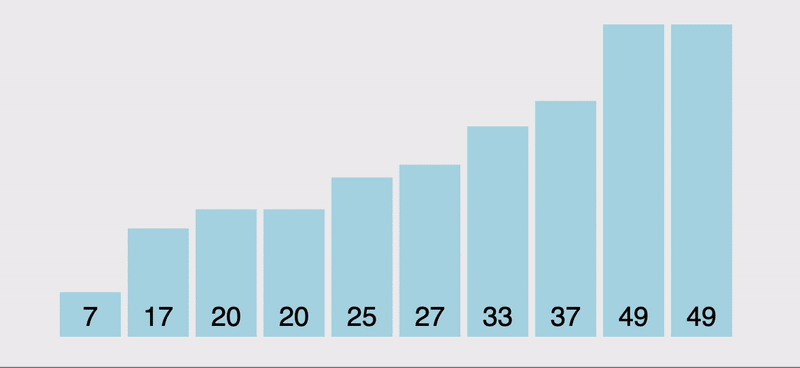
퀵 정렬의 이름보다 흥미로운 부분은 하나의 피벗이 큰 문제를 두 개의 작은 문제로 바꾸는 과정이다. 분할된 배열이 다시 같은 규칙으로 정렬되는 흐름을 순서대로 따라가 봤다.
Quick Sort(퀵 정렬)
배열을 기준값(pivot)을 기준으로 두 개의 하위 배열로 분할하고, 분할된 하위 배열을 재귀적으로 정렬한 뒤, 결합하여 최종적으로 정렬된 배열을 얻는 방식이다. 시간 복잡도는 평균적으로 O(n log n)이며, 최악의 경우 O(n^2)이다. 평균적으로 매우 효율적인 성능을 가지고 있어, 많은 정렬 알고리즘 중에서도 가장 널리 사용된다.
분할 정복 기법(Divide and Conquer)
문제를 여러 개의 작은 부분 문제로 나눈 뒤, 각 부분 문제를 재귀적(recursive)으로 해결하고, 이를 결합하여 원래 문제를 해결하는 방법이다.
재귀 함수(recursive function) 함수가 자기 자신을 호출하여 문제를 해결하는 방식
동작 방식
- 배열에서 하나의 원소를 선택하여 기준값으로 지정한다.
- 기준값을 기준으로 배열을 분할한다. 기준값보다 작은 원소는 왼쪽 하위 배열로, 기준값보다 큰 원소는 오른쪽 하위 배열로 옮긴다.
- 왼쪽 하위 배열과 오른쪽 하위 배열을 각각 재귀적으로 Quick Sort를 호출하여 정렬한다.
- 분할된 배열의 크기가 1 이하일 때까지 반복한다.
- 재귀 호출을 통해 정렬된 왼쪽 하위 배열, 기준값, 정렬된 오른쪽 하위 배열을 순서대로 결합하여 최종적으로 정렬된 배열을 얻는다.